 VECTORIO
Eine Milliarde Zeilen · 32 ms · ein Notebook
Big Data. Ohne Big Cloud.
PROTOR rechnet so schnell, dass die meisten Datenaufgaben keinen Cluster mehr brauchen – auf Ihrer eigenen Hardware, auf Wunsch offline, und jedes Ergebnis mit Nachweis.
SELECT key, SUM(value)
FROM events GROUP BY key -- 1.000.000.000 ZeilenWo Teams einsteigen. Welcher passt zu Ihnen?
Souveränität & Edge
„Keine Cloud. Gestörte Verbindungen. Und das Ergebnis muss Bestand haben.“
Regulatorische Nachweise
„24 Stunden bis zur Meldung. Die Belege liegen in fünf Silos.“
Kosten & Reproduzierbarkeit
„Die Warehouse-Rechnung wächst schneller als die Daten. Und die Zahl vom letzten Quartal lässt sich nicht reproduzieren.“
Verzeichnisse & Kommunikation
„Zwei Gesamtstrukturen, drei Adressbücher – und niemand weiß, wer was geändert hat.“
Forschung & Geodaten
„Das Instrument sprengt die Workstation. Die Warteschlange sprengt Ihre Geduld.“
Fertig vor dem Kaffee.
Bestellen Sie einen Flat White und starten Sie die nächtliche Pipeline über 100 Millionen Ereignisse. Sie ist auf Ihrem Notebook fertig, bevor die Milch geschäumt ist.
- 0 sSie bestellen einen Flat White
Die nächtliche Pipeline startet: 100 Millionen Musik-Streaming-Ereignisse, 9,6 GB CSV.
- 4,8 s100 Millionen Ereignisse gelesen
Sitzungen und Titelkatalog kommen hinzu, während die Ereignisse durchlaufen.
- 34 sDie Pipeline ist fertig
21 Schritte: personenbezogene Daten maskiert, Dubletten entfernt, Qualität geprüft, angereichert und je Tag verdichtet. 122.222 fehlerhafte Zeilen samt Grund beiseitegelegt.
- ≈ 90 sIhr Kaffee kommt
Zeit, die Tagesauswertung zu lesen – und den nächsten Schritt anzupassen.
Gemessen: eine Pipeline mit 21 Schritten über 100 Millionen Musik-Streaming-Ereignisse (9,6 GB CSV), 33,8 s von Anfang bis Ende auf einem Apple-M3-Max-Notebook mit 64 GB; Kaffeezeit zur Veranschaulichung.
Rechnen, wo die Daten entstehen. Übertragen werden nur Ergebnisse.
Sensoren, Kameras, Drohnen und Fahrzeuge führen PROTOR direkt auf dem Gerät aus. Über 5G, Satellit oder eine lokale Funkstrecke – und über 6G, sobald die Netze kommen – gehen nur kleine, signierte Ergebnisse auf die Reise. Die Auswertung läuft weiter, wenn die Verbindung abbricht.
Umweltschutz
Pegel- und Luftgütesensoren schlagen vor Ort Alarm, sobald ein Grenzwert reißt – die Station misst weiter, auch wenn die Verbindung abbricht.
Verkehrssteuerung
Kameras an der Kreuzung zählen und klassifizieren direkt vor Ort; Gesichter und Kennzeichen sind verpixelt, bevor etwas gespeichert wird.
Polizei und Ermittlung
Bodycam-Aufnahmen werden direkt auf dem Gerät anonymisiert und als Beweismittel versiegelt, das jeder später prüfen kann.
Landwirtschaft
Feldsensoren und Drohnenbilder werden direkt auf dem Hof zur Feldkarte – auch ohne schnelle Leitung.
NGOs und Katastrophenhilfe
Schadensmeldungen, Sensordaten und Bilder werden direkt im Krisengebiet ausgewertet – auf einem einzigen robusten Rechner.
Verteidigung und Dual Use
Sensorströme werden am Rand des Netzes zusammengeführt; derselbe Workflow läuft im Fahrzeug, im Gefechtsstand und im Rechenzentrum.
So läuft es. Für Ihren Fall.
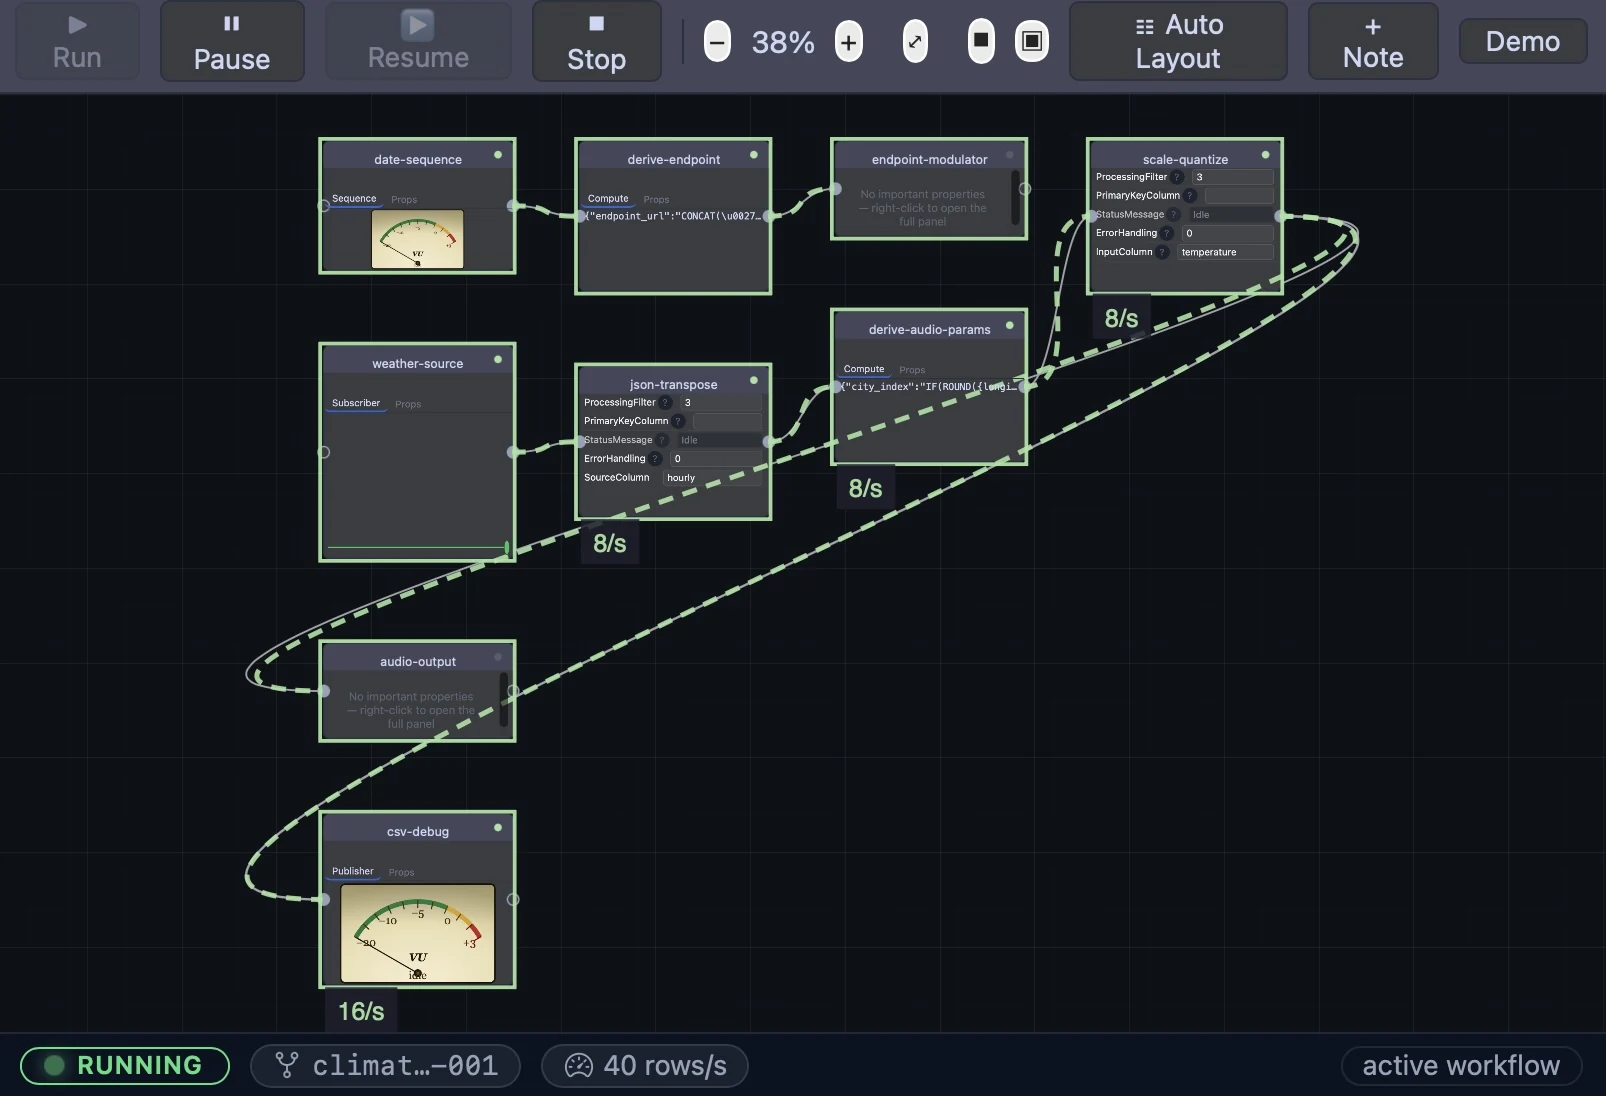
Vier echte Workflows aus unserer Testsuite – auf der Arbeitsfläche gezeichnet, als Datei gespeichert, jeder mit einem signierten Ergebnis auf Ihrer Hardware.
- Videodatei-EingangVideo.File.Subscriber
- Gesichter verpixelnVideo.FaceBlur
- NachweiseNachweis-Sammler
- PaketEvidenzpaket
- AusgabeBinärdatei-Ausgabe
bodycam-input → Video.File.Subscriber
face-redact → Video.FaceBlur
evidence-collect → Forensic.EvidenceCollector
evidence-pack → Forensic.EvidencePack
evidence-output → BinaryFile.Publisher- FinancialZufallsdaten
- TransaktionsnachweisNachweis-Sammler
- Zeilen-Hash · Financial-NachweisSchlüsselerzeugung · Evidenzpaket
- Betragsprüfung · EPK-IntegritätsprüfungQualitätsprüfung · Nachweisprüfung
- Gültige Zahlungen · Abgelehnte ZahlungenCSV-Ausgabe · CSV-Ausgabe
tx-gen → Generators.Random
evidence-collector → Forensic.EvidenceCollector
integrity-hash → ETL.KeyGen
amount-gate → Sync.QualityGate
valid-output → CSV.Publisher
rejected-output → CSV.Publisher
evidence-pack → Forensic.EvidencePack
evidence-verifier → Forensic.EvidenceVerifier- Streaming-Ereignisse · Sitzungskontext · Titeldimension · Schema-AngleichungCSV-Eingang · CSV-Eingang · CSV-Eingang · Schema angleichen
- Zeitstempel · PseudonymisierungFelder berechnen · Schlüsselerzeugung
- Ereignis-ID erzeugen · Dubletten entfernenSchlüsselerzeugung · Dublettenentfernung
- Summen vorbereiten · Sitzungsdaten ergänzen · Titeldaten ergänzen · Tagessumme je NutzerFelder berechnen · Abgleich · Abgleich · Aggregation
- Abgeleitete Spalten · Qualitätsprüfung · Tagessummen-AusgabeFelder berechnen · Sync.QualityGate · CSV-Ausgabe
- Ausgabeverzweigung · Geprüfte Ereignisse · Qualitätsstatistik · Qualitätskennzahlen · DLQ-Fehlerbehandlung · Dead-Letter-AusgabeVerzweigung · CSV-Ausgabe · Fensterfunktionen · CSV-Ausgabe · DLQ-Behandlung · CSV-Ausgabe
event-source → CSV.Subscriber
session-context-source → CSV.Subscriber
tracks-dim-source → CSV.Subscriber
schema-conform → ETL.SchemaConform
timestamp-normalization → ETL.Compute
pii-boundary → ETL.KeyGen
event-key-gen → ETL.KeyGen
dedup → ETL.Dedup
rollup-prep → ETL.Compute
session-enrichment → ETL.Lookup
track-enrichment → ETL.Lookup
derived-columns → ETL.Compute
quality-gate → Sync.QualityGate
output-fork → ETL.Fork
trusted-output → CSV.Publisher
daily-rollup → ETL.Rollup
rollup-output → CSV.Publisher
quality-stats → ETL.Window
quality-output → CSV.Publisher
dlq-handler → ETL.DLQHandler
dlq-output → CSV.Publisher- Camelyon16-LeserPyramiden-TIFF
- GewebeerkennungGewebedetektor
- H&E-SeparationFarbseparation
- TexturmerkmaleMerkmalsextraktion
- Merkmals-CSV-ExportCSV-Ausgabe
wsi-read → Image.PyramidalTiff.Subscriber
tissue-detect → Health.TissueDetect
stain-deconv → Health.StainDeconv
features → Classification.Features
csv-out → CSV.PublisherEchte Workflows und Knotentypen; die Designer-Ansicht ist illustriert und entwickelt sich mit dem Produkt weiter. Messwerte stammen aus unseren End-to-End-Testläufen.
Gemessen auf einem Notebook der Apple-M3-Max-Klasse, 16 Kerne, 64 GB, nur CPU; 1 Kaltlauf + 5 Warmläufe; logische dekodierte GB/s. Methode und Rohtabelle →
Weniger Werkzeuge. Weniger Rechnungen.
Die meisten Teams verbinden fünf Produkte, um eine einzige Antwort zu erhalten. PROTOR erledigt die ganze Aufgabe in einer Runtime – mit weniger Lizenzen und weniger beweglichen Teilen.
- Cloud-Warehouse
- ETL- und Ingestion-Werkzeug
- Streaming-Plattform
- Orchestrator
- Lineage- & Audit-Werkzeug
5 Anbieter · 5 Rechnungen · 5 Kopien Ihrer Daten
 Eine RuntimeLaden · bereinigen · verknüpfen · prüfen · ausliefern
Auf dem Notebook, dem Server, dem Edge-Gerät oder dem eigenen Cluster – mit Nachweis für jedes Ergebnis.
Was sich für Sie ändert.
Belastbare Ergebnisse
Zu jedem Ergebnis gehört ein Nachweis, wie es entstanden ist. Geben Sie ihn Prüfern, Kunden oder der Aufsicht.
Jedes Mal dieselbe Zahl
Führen Sie den Bericht des letzten Quartals erneut aus – und erhalten Sie dieselbe Zahl wie damals, auf jeder Maschine.
Big-Data-Tempo auf dem Notebook
Eine Milliarde Zeilen in 32 ms. Viele Aufgaben laufen ganz ohne Cluster – und ohne Cluster-Rechnung.
Ihre Daten bleiben zu Hause
Vom kleinen Edge-Gerät bis zum eigenen Cluster, bei Bedarf offline. Nichts verlässt Ihr Haus.
Ihre Daten. Ihre Hardware. Ihre Regeln.
PROTOR läuft dort, wo Ihre Daten schon sind – auf dem Notebook, dem Server, dem Edge-Gerät oder in einem abgeschotteten Netz. Das entscheidet, wer die Daten sieht, was passiert, wenn die Leitung ausfällt, und was Sie bezahlen.
Vertraulich ab Werk
Ihre Daten bleiben auf Ihrer eigenen Hardware. Kundendaten, Patientendaten und Geschäftsgeheimnisse fließen in die Analyse ein und bleiben, wo sie sind.
Läuft vollständig abgeschottet
Ohne Verbindung – im Fahrzeug, im Werk, im Labor oder im gesicherten Netz. Dieselbe Engine, dieselben Ergebnisse.
Verlässlich ohne Netz
Kein Cloud-Ausfall, kein Ratenlimit, keine Warteschlange für einen Cluster. Läuft die Maschine, läuft die Analyse.
Eine planbare Lizenz
Eine Lizenz für Ihre eigene Hardware. Keine Abrechnung pro Abfrage, keine Egress-Gebühren, keine Überraschung am Monatsende.
Vom Satelliten bis auf die Straße. Auf einer Maschine.
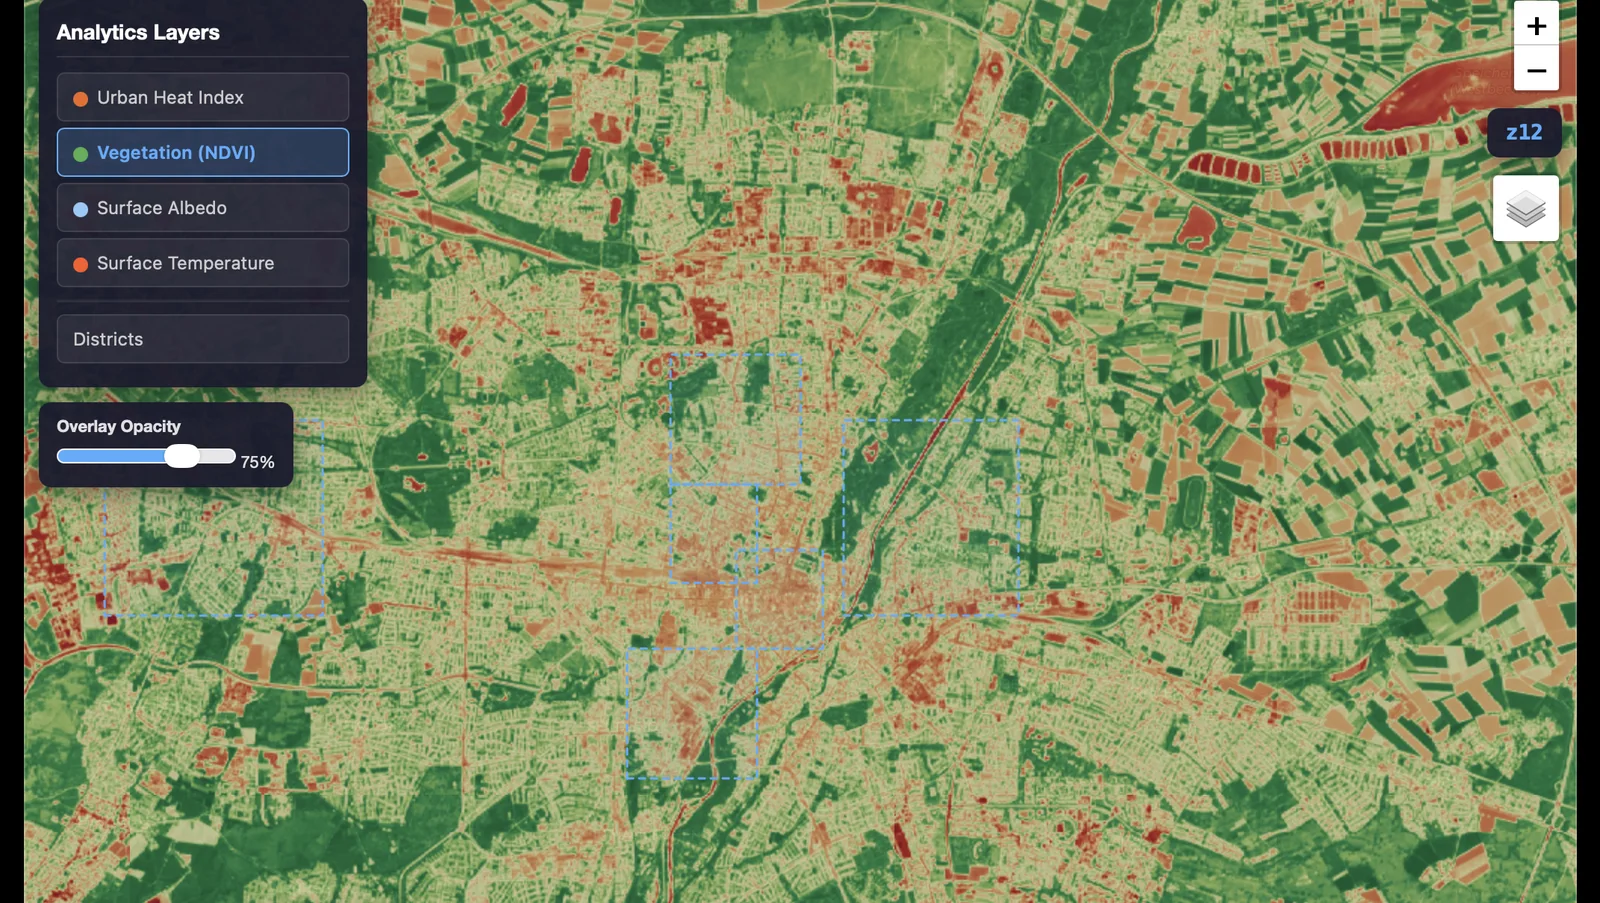
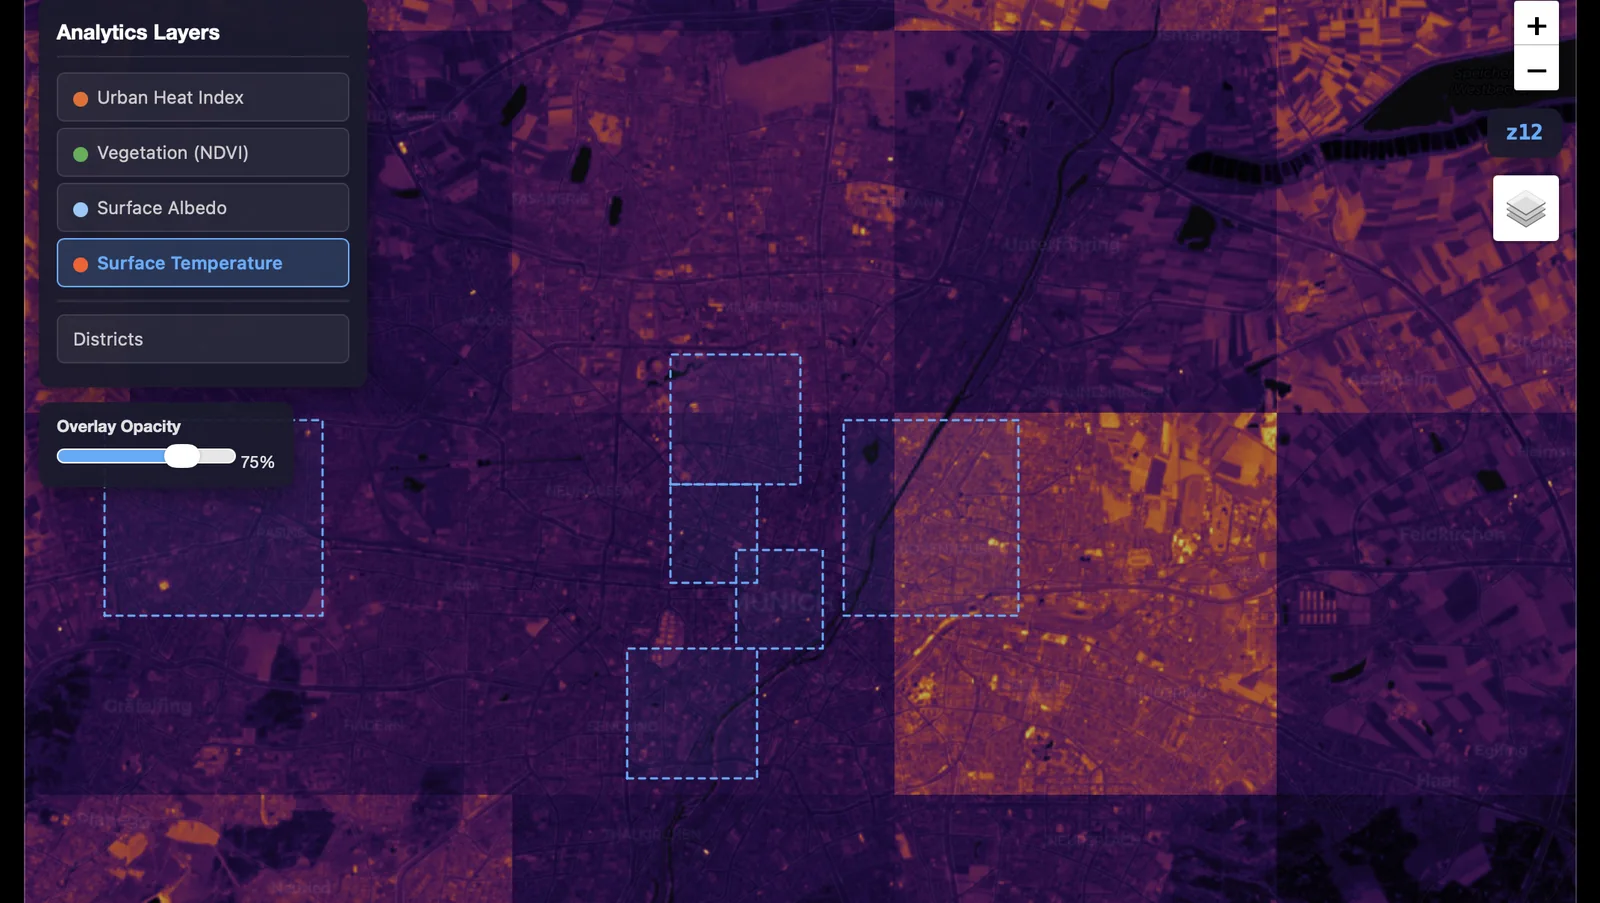
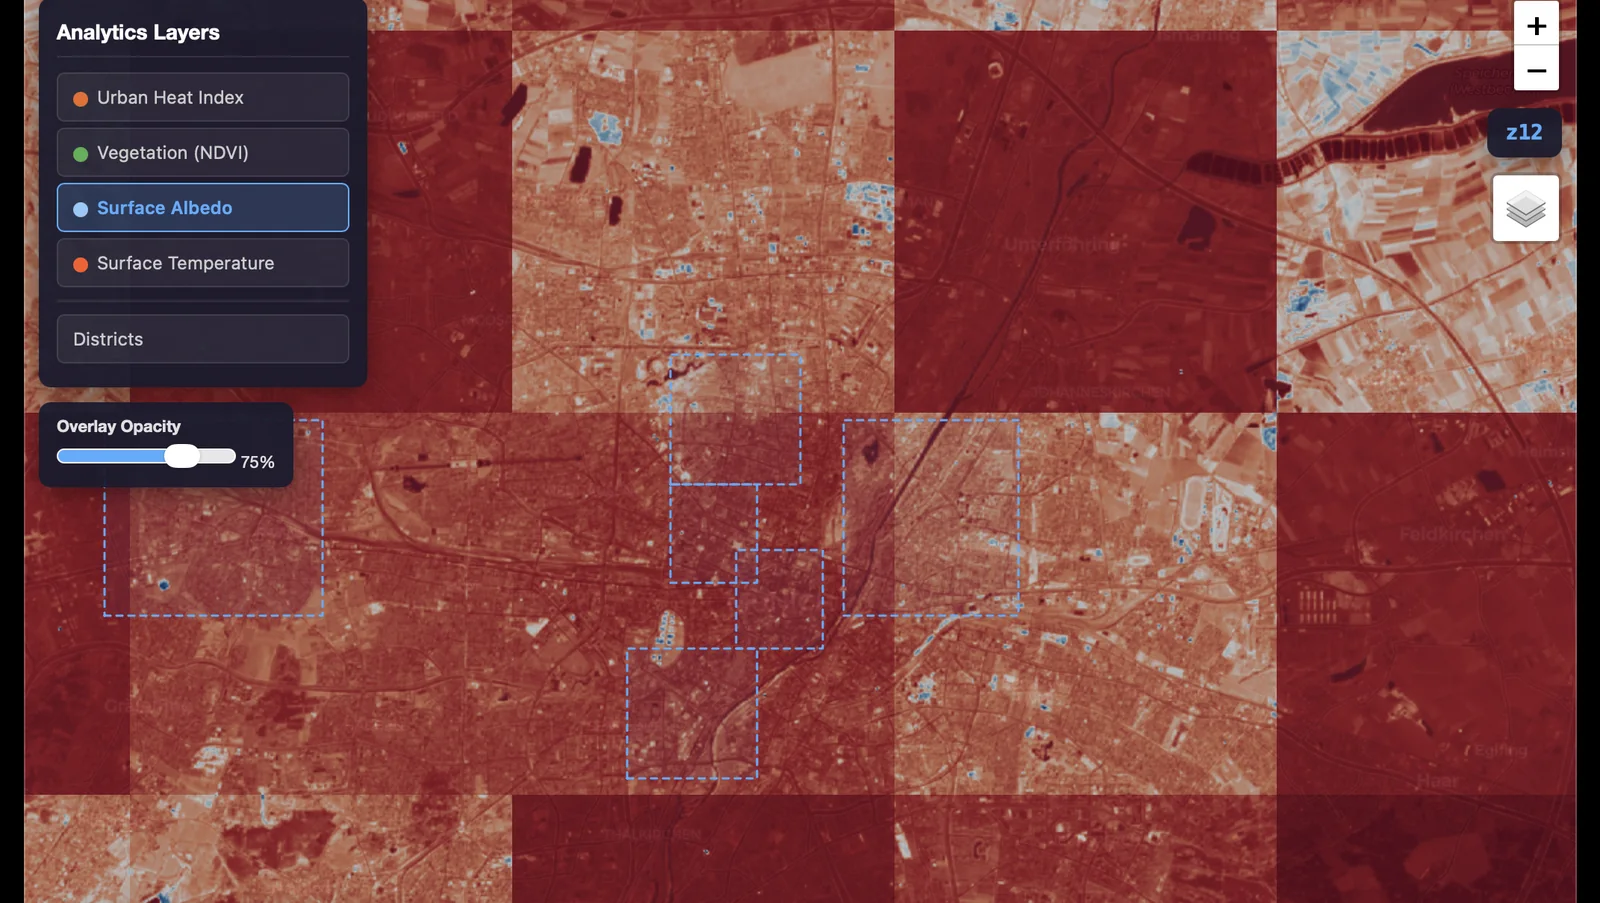
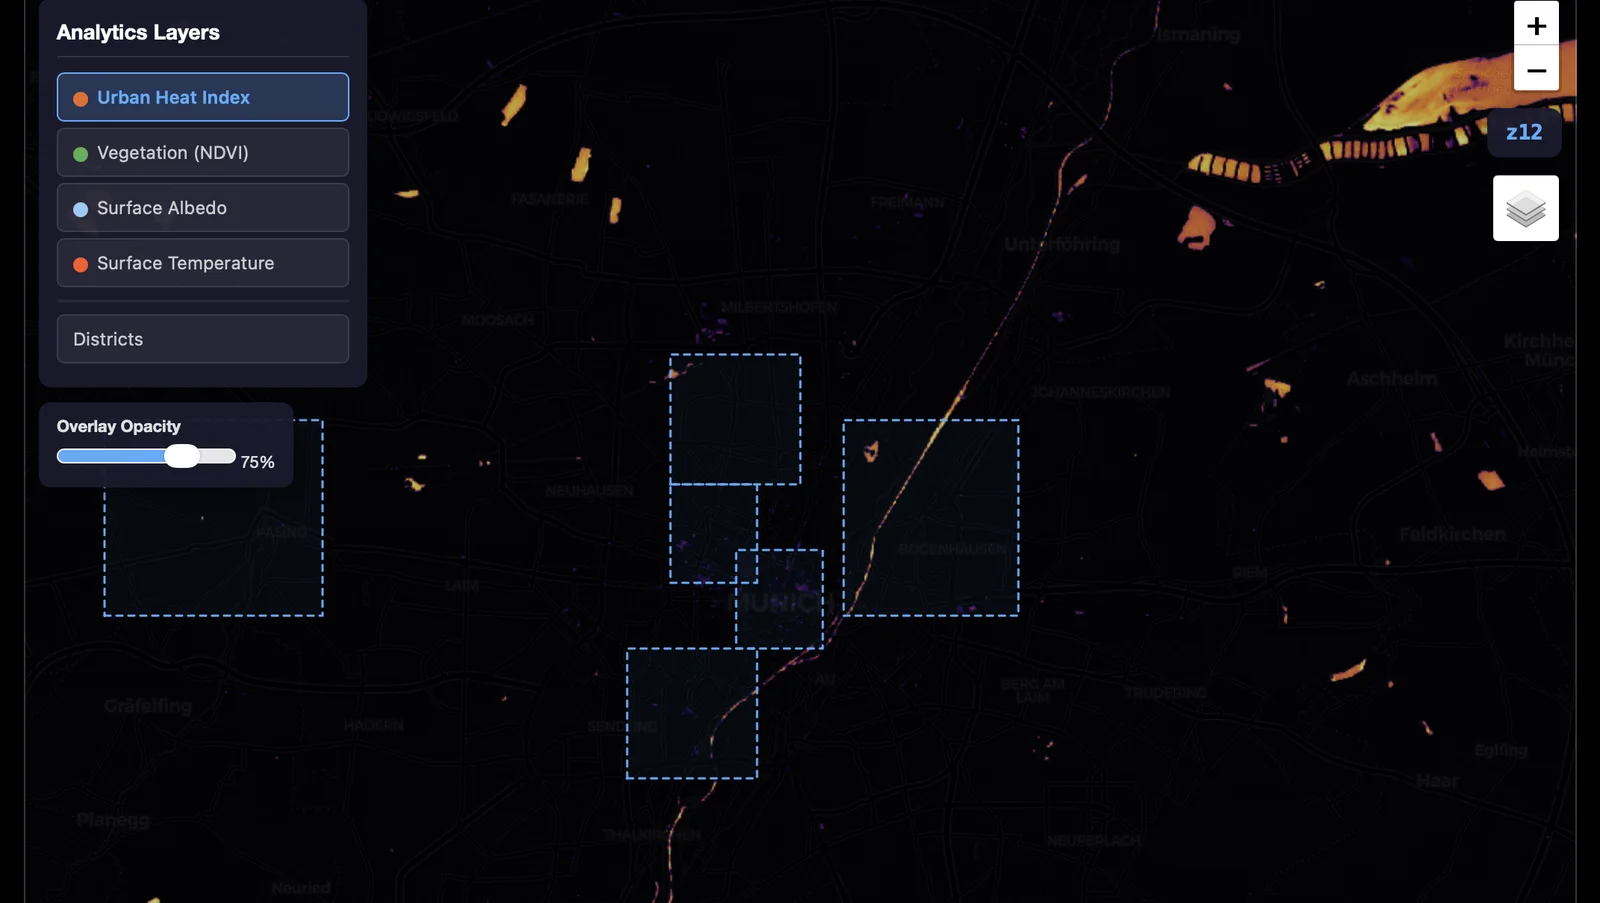
Münchens heißeste Straßen, kartiert aus Sentinel-2-Aufnahmen: Vegetation, Oberflächentemperatur und Hitze – geliefert als signierte Karte.
Drei Produkte. Eine Idee.
Alle drei behalten Ihre Daten bei Ihnen – und zeigen, woher jedes Ergebnis stammt.
 PROTOR
ETL, SQL, Streaming und Workflows in einer Laufzeitumgebung – vom Notebook bis zum Cluster.
PROTOR kennenlernen Verzeichnis-SynchronisationConnectype
Adresslisten, Benutzer und Gruppen im Gleichklang über Verzeichnisse und Dateien – mit Vorschau, Löschgrenze und Prüfpfad. Gebaut auf PROTOR.
Connectype kennenlernen
 INDAGO
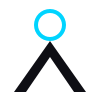
Findet die genaue Seite in Ihren Dokumenten in Millisekunden – auf Ihrem Mac, mit Quelle.
indago.oneKlein anfangen. Behalten, was Sie haben.
Jedes Produkt startet neben den Werkzeugen, die Sie schon nutzen. Sie sehen zuerst das Ergebnis und entscheiden danach.
Ein Job, neben Ihrem Stack
Nehmen Sie den Nachtjob mit der höchsten Rechnung. Lassen Sie ihn auf einem Notebook neben Ihrer bisherigen Plattform laufen und vergleichen Sie die Zahlen.
ein Job · eine WocheZwei Verzeichnisse, nur Vorschau
Richten Sie Connectype auf eine Kopie zweier Verzeichnisse. Lesen Sie die Vorschau. Geschrieben wird erst mit Ihrer Zustimmung.
ein NachmittagEin Ordner, eine Frage
Fügen Sie den Ordner hinzu, den Sie am häufigsten durchsuchen, und stellen Sie die Frage von letzter Woche.
fünf MinutenZeigen Sie uns Ihr schwierigstes Datenproblem. Wir lösen es gemeinsam.
Ein kurzes Pilotprojekt mit Ihren Daten auf Ihrer Hardware. Was Erfolg bedeutet, legen wir vorher gemeinsam fest.